🔹 RAG (Пошук перед відповіддю)
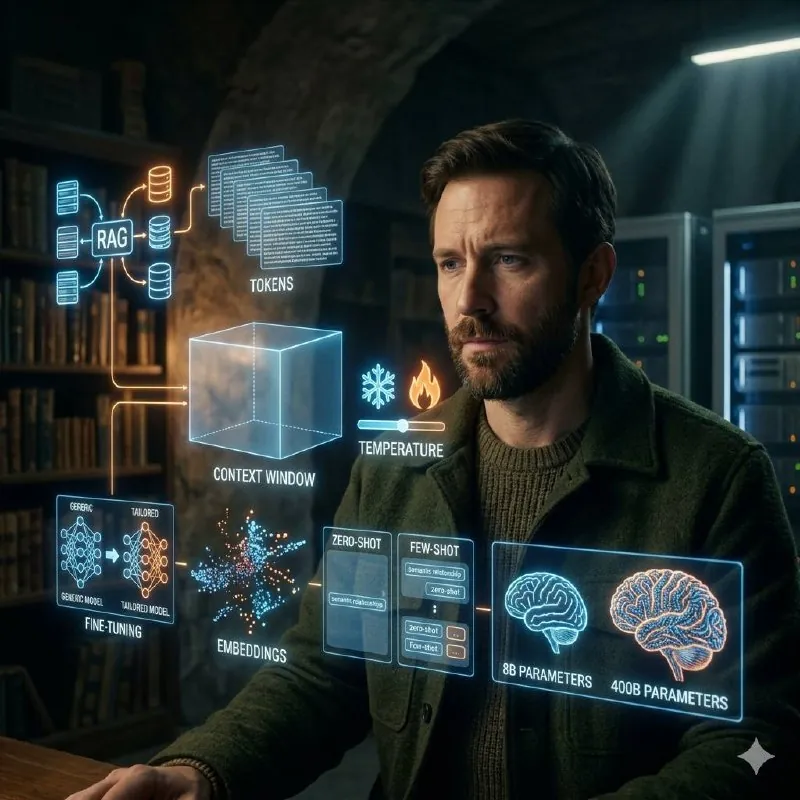
Що це: Архітектура, яка змушує нейромережу шукати актуальну інформацію у зовнішніх базах даних перед тим, як згенерувати відповідь (на відміну від звичайної генерації лише з власної пам'яті).
Як це працює: Це як екзамен з відкритою книгою. Ви підключаєте ШІ до папки з робочими документами. Коли ви питаєте «Яка в нас політика відпусток?», ШІ не фантазує, а знаходить конкретний PDF-файл, читає його і дає точну відповідь на основі саме ваших даних.
🔹 Токени (Tokens)
Що це: Базові одиниці даних, на які алгоритм розбиває текст для обробки. Це не обов'язково цілі слова — частіше це набори літер або окремі символи.
Як це працює: Коротке слово «кіт» — це 1 токен. А довге «заробіток» ШІ розіб'є на «за», «роб» та «іток» (3 токени). Коли ви платите за використання платних версій ШІ, ви платите саме за ці шматочки обробленої інформації. Для розуміння: 1000 токенів — це приблизно стаття на 2 сторінки.
🔹 Контекстне вікно (Context Window)
Що це: Максимальний обсяг інформації (у токенах), який модель здатна аналізувати та тримати в «оперативній пам'яті» одночасно під час однієї сесії.
Як це працює: Це те, скільки ШІ пам'ятає, перш ніж забуде початок бесіди. Сучасні моделі мають вікно у 128 000 і більше токенів. Це означає, що ви можете завантажити в чат цілу книгу про Гаррі Поттера, і ШІ врахує кожну сторінку, відповідаючи на ваші питання по тексту.
🔹 Температура (Temperature)
Що це: Математичний параметр моделі (від 0 до 2), який контролює рівень випадковості при виборі наступного слова під час генерації тексту.
Як це працює: 🧊 Низька (0.1): Режим «бухгалтер». ШІ обирає найбільш ймовірні слова. Відповідь суха і точна. Ідеально для коду або роботи з цифрами.
🔥 Висока (0.8+): Режим «поет». ШІ обирає менш ймовірні варіанти. Текст стає креативним, незвичним, але є ризик, що ШІ напише нісенітницю.
🔹 Файн-тюнінг (Fine-tuning)
Що це: Процес додаткового тренування вже навченої базової нейромережі на вузькоспеціалізованих або ваших власних наборах даних.
Як це працює: Це як відправити студента-медика на вузьку спеціалізацію хірурга. Ви берете звичайну нейромережу і «згодовуєте» їй 500 ваших найкращих постів. Після цього ШІ починає писати тексти точно у вашому авторському стилі, використовуючи ваші фірмові слова.
🔹 Ембединги (Embeddings)
Що це: Векторне (числове) представлення тексту або зображень. Це математичний спосіб перетворити слова у координати на багатовимірній мапі.
Як це працює: ШІ не розуміє літер. Але завдяки ембедингам на його математичній мапі координати слів «король» і «королева» знаходяться поруч. Тому, коли ви шукаєте в магазині «зимовий одяг», пошук покаже вам «пуховики» і «шапки», хоча ви не вводили ці слова. Він розуміє сенс, а не просто шукає збіг літер.
🔹 Zero-shot та Few-shot (Як ставити задачі)
Що це: Методи побудови промптів (запитів), які визначають, скільки контексту ви даєте моделі перед виконанням завдання.
Як це працює: 🎯 Zero-shot (з нуля): Ви пишете «Напиши пост про огірок». ШІ генерує його без орієнтирів.
📝 Few-shot (з прикладами): Ви пишете «Ось приклад посту про кабачок. Ось приклад про томат. А тепер напиши пост про огірок в такому ж стилі». Результат буде в рази точнішим!
🔹 Параметри (Parameters)
Що це: Внутрішні налаштування моделі (числові ваги), які формуються під час її навчання і визначають силу зв'язку між штучними нейронами. По суті, це обсяг «знань» і складності нейромережі.
Як це працює: Коли пишуть про «модель на 8B» (8 мільярдів параметрів) — це легка програма, яку можна запустити навіть на потужному смартфоні. А от «модель на 400B» — це гігант, для роботи якого потрібні цілі зали серверів, але він здатний вирішувати завдання рівня доктора наук.